WordPressサイトのrobots.txtを開いたら、突然すべてのページがクロール拒否になっていたり、
見覚えのない海外ドメインのサイトマップが追加されていたりして困っていませんか?
robots.txtは小さなテキストですが、検索エンジンがサイト内のURLへアクセスする判断に使います。
マルウェアに書き換えられると、正常ページの巡回を妨げたり、不正URLへクローラーを誘導したりするおそれがあります。
ただし、異常な内容を見つけてすぐ上書きすると、侵入時刻や生成元の手掛かりを失います。
まず外部から見える応答を保存し、実ファイル・WordPressの仮想出力・プラグイン・CDNのどこが返しているかを分けることが重要です。
 よこやま良平
WordPressの復旧を多数手がけてきたよこやま良平です。わたしの現場経験をもとに、robots.txt改ざんの証拠を残し、生成元を止めて安全に復旧・再登録する順番を解説します。
- robots.txtの異常を最初に確認する方法
- 実ファイルとWordPressの仮想robots.txtを見分ける考え方
- 悪意あるDisallow・Allow・Sitemapの判断基準
- 改ざん元をファイル・プラグイン・DB・CDNから追う手順
- 正常なルールへ復旧して検索エンジンへ反映する方法
- 再書き換えを検知して再感染を防ぐ監視項目
結論から言うと、robots.txtだけを直しても復旧にはなりません。
現在の応答を保全し、生成経路と侵入経路を止め、サイト構成に合う最小限のルールへ戻す必要があります。
復旧後は、同じURLを複数の経路から再確認し、Search Consoleとサーバーログで巡回の回復を見ます。
何を・なぜ・どの順番で確認するかを、初心者にも分かる形で進めましょう。
こんなお悩みはありませんか?
- ある朝、サイトを開いたら真っ白画面になっていた
- 管理画面にログインできなくなって手が止まった
- 身に覚えのない記事やページが勝手に増えていた
- プラグインを更新したらサイト全体が崩れてしまった
- 以前バックアップを取ったか自分でも覚えていない
累計1,000件以上のWordPressトラブル対応の経験から、「壊れる前に備える」ためのチェックリストを1冊にまとめました。
ログイン・本体・バックアップ・サーバー・運用の5分野を、50項目で「危険度・確認方法・対処法」まで解説しています。
セキュリティプラグイン・WordPressの教科書も含めた3大特典を、
今なら無料で受け取れます。
WordPressのrobots.txt改ざんは外部応答の保存から始める
WordPressのrobots.txtに異常を見つけた時は、管理画面やFTPで編集する前に、
訪問者と検索エンジンへ実際に返っている内容を保存するのが最初の作業です。
サーバー内のファイルと公開応答が一致するとは限りません。
WordPressの仮想出力、SEOプラグイン、Webサーバー、CDNキャッシュが別の内容を返す場合があるためです。
robots.txtの本文・HTTP状態・ヘッダーを同時に記録する
ブラウザーの表示だけをスクリーンショットにするのではなく、本文、取得日時、HTTP状態、
Content-Type、キャッシュ関連ヘッダー、最終URLを一組で保存します。
curl -sS -D robots-headers.txt -o robots-body.txt https://example.com/robots.txt
curl -sS -A 'Googlebot' -D robots-googlebot-headers.txt -o robots-googlebot-body.txt https://example.com/robots.txt
shasum -a 256 robots-body.txt robots-googlebot-body.txtrobots.txtはサイトのルート、たとえばhttps://example.com/robots.txtに置かれます。
サブディレクトリの同名ファイルを確認しても、ルートのホスト全体へ同じようには適用されません。
www・非www・HTTP・HTTPS・CDN経由を分けて確認する
robots.txtのルールは、配置されたプロトコル・ホスト・ポートの範囲に適用されます。
wwwありとなし、HTTPからHTTPSへの転送、CDNを通る公開URLを同一扱いにせず、それぞれの最終応答を記録します。
- robots.txtの本文と取得日時
- HTTP状態・Content-Type・Location・キャッシュヘッダー
- 通常User-Agentと検索クローラーで取得した結果
- www・非www・HTTP・HTTPSの最終URL
- 異常を発見したSearch Console通知や検索画面
- 直前に行った更新・移行・プラグイン変更の履歴
同時に不正転送や未知のページが見つかった場合は、robots.txtだけのSEO設定問題として扱いません。
サイト全体の改ざんとして公開制限と証拠保全を優先してください。
WordPressのrobots.txtが悪意ある改ざんか内容で見分ける
robots.txtの内容が普段と違うだけでは、直ちにマルウェアと断定できません。
正規のSEO設定変更、ステージング公開防止、プラグイン更新でも内容は変わるからです。
全面拒否と重要ディレクトリの拒否を確認する
User-agent: *に対するDisallow: /は、協力的なクローラーへサイト全体を巡回しないよう求める指定です。
公開サイトで意図せず追加されていれば、重要な異常として扱います。
商品、記事、画像、CSSやJavaScriptなど、検索表示やページ理解に必要な場所だけを狙って拒否している場合も要注意です。
ただし管理画面など正規に拒否する場所もあるため、パス名だけでなく本来の用途と照合します。
外部Sitemapとスパム用パスの許可を確認する
Sitemap:には完全なURLを指定できますが、自社と無関係なドメインや身に覚えのないXMLが書かれていれば、
検索スパムの一部として追加された可能性があります。
不正な商品名、賭博、薬品、偽ブランドなどのパスだけをAllowし、
正常なページをDisallowしている組み合わせは、検索クローラーをスパムページへ集中させる意図が疑われます。
- 公開サイトなのに全体へDisallow: /が追加されている
- 正常な記事・商品・画像・CSSだけが拒否されている
- 自社と無関係な外部ドメインのSitemapがある
- 不正キーワードのパスだけがAllowされている
- Googlebotなど特定クローラー向けだけ内容が違う
- 同時期に不正ページ・転送・管理者・PHP変更も見つかる
知らないサイトマップや大量の不正URLがすでに検索へ出ている場合は、
robots.txt修正だけでなく、生成元の停止、URL応答の正常化、インデックス確認が必要です。
賭博系や外国語の不正ページが増えている場合は、感染範囲がファイルだけでなく投稿・DB・テンプレートへ広がっていないかも確認します。
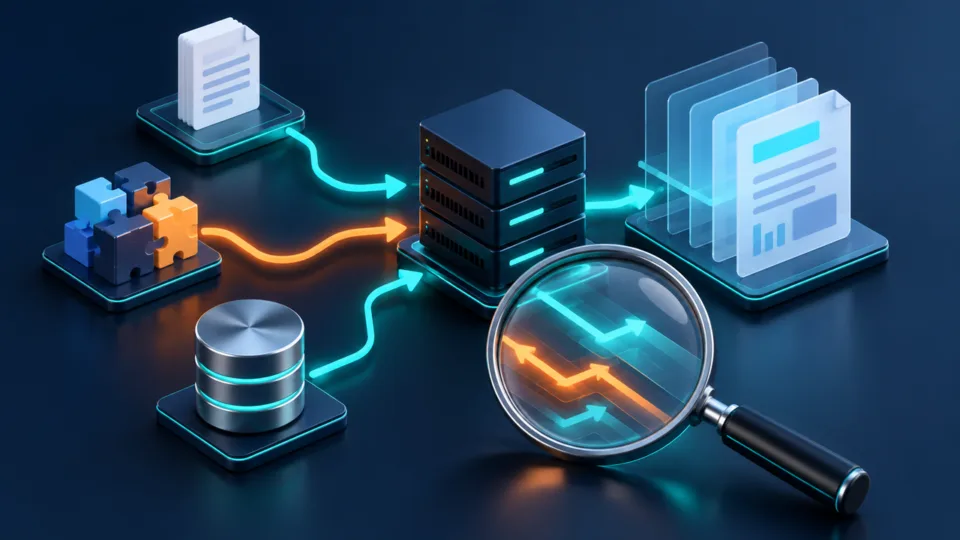
WordPressのrobots.txtを実ファイル・仮想出力・キャッシュに分ける
robots.txtの復旧で最も重要なのは、今見えている本文を誰が生成しているかを特定することです。
生成元を間違えると、ルートのファイルを直しても表示が変わらず、別の正常設定を壊すことがあります。
ルートの物理ファイルがあるか確認する
まずドキュメントルートにrobots.txtという実ファイルがあるか確認します。
存在する場合は、内容、SHA-256、容量、更新日時、所有者、グループ、パーミッションを保存してください。
同一サーバーに複数サイトがあるなら、対象ドメインのドキュメントルートを先に確定します。
似た名前のバックアップ領域や旧サイトのrobots.txtを調べても、公開応答の説明にはなりません。
stat /path/to/public_html/robots.txt
shasum -a 256 /path/to/public_html/robots.txt
cp -p /path/to/public_html/robots.txt /safe/evidence/robots.txt.suspect
ファイルがある場合でも、Webサーバー設定やCDNが別の応答へ置き換えている可能性があります。
保存した公開本文と実ファイルのハッシュ・内容を比較して、一致するかを確認します。
WordPressの仮想robots.txtとフィルターを確認する
ルートに実ファイルがない場合、WordPressはdo_robots()によって仮想的なrobots.txtを出力できます。
さらにrobots_txtフィルターやdo_robotstxtアクションで、プラグインやテーマが内容を変更できます。
SEOプラグインの設定だけでなく、通常プラグイン、mu-plugins、テーマのfunctions.php、
コードスニペット、独自プラグインからrobots_txtやdo_robotstxtを検索します。
grep -RIn --exclude-dir=vendor --exclude-dir=node_modules \
  -E "robots_txt|do_robotstxt|robots\.txt" wp-content/mu-plugins wp-content/plugins wp-content/themes
検索結果があること自体は感染の証拠ではありません。配布元、導入目的、管理者の変更履歴、
実際に出力される文字列を照合し、正規カスタマイズと不正追加を分けます。
CDN・ページキャッシュ・Webサーバーの応答を確認する
WordPress側を直しても公開内容が変わらない時は、CDNやサーバーキャッシュが古いrobots.txtを返していないか確認します。Age、Cache-Control、ETag、CDN固有ヘッダーを修正前後で比べてください。
NginxやApacheの固定レスポンス、リダイレクト、セキュリティ製品のルールが生成している場合もあります。
プラグイン停止を繰り返す前に、公開応答がWordPressまで到達しているかを切り分けます。
- 公開robots.txtとレスポンスヘッダーを保存する
- ドキュメントルートの物理robots.txt有無を確認する
- WordPressのrobots_txt・do_robotstxt呼び出し元を探す
- SEOプラグイン・コードスニペット・独自設定を照合する
- Webサーバー・CDN・キャッシュの固定応答を確認する
- www・非wwwなど別ホストでも同じ生成元か確かめる
コードだけでなくデータベースに不正な実行内容や設定が保存されるケースもあります。
スキャンで見つからない不正処理をDBから調べる考え方は、次の記事も参考になります。
WordPressのrobots.txtを書き換えた侵入経路を止める
生成元を特定したら、robots.txtの復元より先に書き換え元と侵入経路を止めます。
不正ファイル、盗まれた認証情報、Cron、脆弱なプラグインが残れば、修正後に同じ内容が戻るためです。
更新時刻をアクセス・認証・Cronのログと照合する
物理ファイルの更新時刻、プラグイン設定の変更時刻、キャッシュ更新時刻を基準に、
アクセスログ、管理者ログイン、FTP・SFTP・SSH、サーバー管理画面、WordPress Cronを並べます。
時刻は移行や攻撃者の操作で変わるため、単独では犯人を断定できません。
同時刻に作成されたPHP、未知の管理者、外部通信、設定変更があるかを複数の記録で確認します。
不正な生成コードと再投入元を隔離する
robots.txtを書き換えるコードを見つけても、その一行だけ削除して終わらせません。
コードを設置した入口、同じ特徴を持つ別ファイル、一定間隔で戻すCronや外部タスクを追います。
不審ファイルは公開領域外へ証拠として隔離し、ハッシュと元の絶対パスを記録します。
本番上で実行して挙動を確かめたり、ファイル名だけを変えて公開領域に残したりしないでください。
無効に見えるバックドアでも、別条件や攻撃者の再訪問で動くことがあります。
削除前の保全と関連箇所の確認方法は、次の記事で整理しています。
認証情報と同居サイトを同じ復旧範囲に含める
管理者、Application Passwords、SFTP、SSH、サーバー管理画面、CDN、DNSの認証を確認します。
変更は安全確認済みの端末とメールから行い、不要セッションや未知のキーを失効してください。
同じホスティングアカウントの別WordPress、旧CMS、検証サイトから書き戻される場合があります。
対象サイトだけでなく、同一ユーザーが書き込める公開領域とCronを棚卸しします。
- WordPress管理者・Application Passwords・有効セッション
- FTP・SFTP・SSH・サーバー管理画面・CDN・DNS
- テーマ・通常プラグイン・mu-plugins・コードスニペット
- WordPress Cron・サーバーCron・外部自動化
- uploads・cache・tmpなど書き込み可能な場所
- 同一アカウントの別サイト・旧CMS・バックアップ領域
wp-config.phpまで改ざんされている場合は、DB情報や認証キーの扱いが変わります。
robots.txtとは別に、設定ファイルの保全と認証変更を正しい順番で進めてください。
WordPressのrobots.txtを正常ルールへ復旧して再登録する
侵入口と再生成元を止めた後、サイト構成に合うrobots.txtへ復旧します。
他サイトのテンプレートをそのままコピーせず、必要な巡回、拒否する管理領域、正規サイトマップを確認して最小限にします。
正規バックアップと運用要件からルールを再構成する
改ざん前のバックアップがあり、作成日時と安全性を確認できるなら、差分を調べて正規ルールの参考にします。
バックアップがない場合は、WordPressの標準出力と現在のSEO要件から一行ずつ再設計します。
WordPressの標準出力では管理画面パスを拒否し、admin-ajax.phpを許可する形が使われます。
ただしサブディレクトリ設置、会員サイト、EC、複数言語、独自検索などでは必要なパスが異なります。
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/wp-sitemap.xml
この例は完成品ではありません。実際のホスト、設置パス、サイトマップURL、公開方針へ合わせ、
不要な拒否や外部Sitemapが残っていないことを確認してください。
HTTP 200・text/plain・UTF-8・構文を確認する
復旧後はシークレットウィンドウとコマンドの両方で取得し、HTTP 200、本文、最終URL、text/plain、UTF-8、改行、User-agentグループ、Disallow・Allow・Sitemapの構文を確認します。
拒否対象の大文字・小文字、末尾スラッシュ、ワイルドカードで範囲が変わります。
重要ページ、画像、CSS、JavaScript、サイトマップを意図せず止めていないか、URL単位でテストします。
robots.txtはアクセス制御ではありません。攻撃者やすべてのBotを強制的に止める仕組みではなく、
秘密ページを守る用途にも使えないため、認証・WAF・公開範囲の設定は別に行います。
Search Consoleで検証しサイトマップを再確認する
Search Consoleのrobots.txtレポートで取得状態と構文上の問題を確認します。
Googleは更新されたrobots.txtを自動的に見つけますが、キャッシュ更新を急ぐ場合は更新通知の手順を利用します。
不正なサイトマップが登録されていたなら、生成元を止めて不正URLの応答を正常化した後、
正規サイトマップだけを確認します。robots.txt修正だけで検索結果から不正URLが即座に消えるわけではありません。
- 公開robots.txtがHTTP 200で意図した本文を返す
- www・非www・HTTP・HTTPSの転送先が正しい
- 通常User-Agentと検索クローラーで不審な差がない
- 正常ページ・画像・CSS・JS・サイトマップを拒否していない
- 外部の不正Sitemapやスパム用Allowが残っていない
- Search Consoleとサーバーログで巡回回復を確認できる
WordPressのrobots.txt再改ざんを時間を分けて監視する
robots.txtが正常表示へ戻った直後だけでは、復旧完了と判断できません。
Cronや攻撃者の再訪問、CDN再同期で、数時間後に不正内容が戻る場合があるためです。
直後・24時間後・72時間後・一週間後に同じ方法で比較する
毎回同じURL、User-Agent、コマンド、保存先を使い、本文ハッシュ、ヘッダー、更新時刻を比較します。
比較条件をそろえると、正常なキャッシュ更新と再感染による変更を分けやすくなります。
再発時は再び上書きせず、変化した時刻の直前にあるアクセス、Cron、ログイン、ファイル変更を保存します。
再発間隔が一定なら定期処理、特定URLへのアクセス後なら外部侵入経路を優先します。
ファイル変更・検索状況・サーバーログを一緒に監視する
robots.txtだけを監視すると、攻撃者が別の場所へ移った時に見逃します。
ルートファイル、wp-content、管理者、Cron、サイトマップ、検索クエリ、404や転送の増加も同じ期間で確認します。
- WordPress本体・テーマ・プラグインを安全に更新する
- 不要な管理者・プラグイン・テーマ・公開ファイルを整理する
- 管理者・サーバー・CDN・DNSの多要素認証を有効にする
- robots.txt本文とハッシュの変更通知を設定する
- Search Consoleのセキュリティ・インデックス・サイトマップを確認する
- 同居サイトとバックアップに感染を持ち越していないか再確認する
再発時刻をアクセスログと照合することで、外部リクエストと内部変更の関係を追えます。
駆除後のログ確認を継続する場合は、次の記事の基準も利用してください。
WordPressのrobots.txt改ざんでよくある質問
WordPressのrobots.txt改ざんは生成元を止めてから復旧する
WordPressのrobots.txtに異常を見つけたら、最初に公開応答、ヘッダー、User-Agent差、
ホスト差を保存し、実ファイル・仮想出力・プラグイン・Webサーバー・CDNのどこが返しているかを分けます。
次に更新時刻とアクセス・認証・Cronログを照合し、不正な生成コード、再投入元、侵入経路を止めます。
その後にサイト構成へ合う最小限のルールへ戻し、HTTP応答、構文、重要URL、Search Consoleを検証してください。
復旧直後だけでなく、24時間後、72時間後、一週間後にも同じ条件で再取得します。
再発した時は上書きを繰り返さず、変化時刻の手掛かりから残っている侵入経路を追うことが大切です。
WordPressのrobots.txt改ざんを自分で復旧できない時は
robots.txtの生成元、改ざん範囲、侵入経路、不正ページ、検索エンジンへの影響を判断できない場合は、
クイックレスキューが証拠保全、感染調査、正常復旧、再発防止まで対応します。
- robots.txtを直しても不正内容へ戻ってしまう
- 物理ファイルがないのに改ざん内容が表示される
- 不正なSitemapや検索スパムも見つかった
- プラグイン・DB・CDNのどこが生成元か分からない
- サイトを壊さず検索巡回を正常化したい